Коротко
Мы перестроили voice-агента с нуля. Voice Agent v2 выходит сегодня с задержкой первого токена менее 200 мс (было 600 мс), нативным переключением языков на 14 языках и на 40% более низкой стоимостью за минуту. Существующие клиенты будут мигрированы автоматически в течение двух недель.
Если вы когда-нибудь чувствовали, что voice AI «почти у цели», v2, это версия, которая переходит эту черту.
Зачем переписывать
Voice Agent v1 был хорош. Клиенты были довольны. Но мы постоянно упирались в одни и те же три ограничения: latency, минимум 500-700мс, переключение языков требовало перенастройки, стоимость за минуту не могла опуститься ниже $0.08.
У каждого из этих ограничений была своя первопричина. Latency, проблема цепочки сервисов. Многоязычность, проблема выбора модели. Стоимость, архитектурная проблема. Чтобы исправить их, нужно было переписать весь стек, что мы и сделали за последние 8 месяцев.
Задержка: 600мс → 180мс
Старый pipeline выполнял ASR → LLM → TTS последовательно: каждый этап ждал завершения предыдущего. Новый pipeline передаёт partials между этапами. ASR partials триггерят токены LLM ещё до того, как пользователь закончит говорить. Токены LLM стримятся в TTS, пока ещё генерируются.
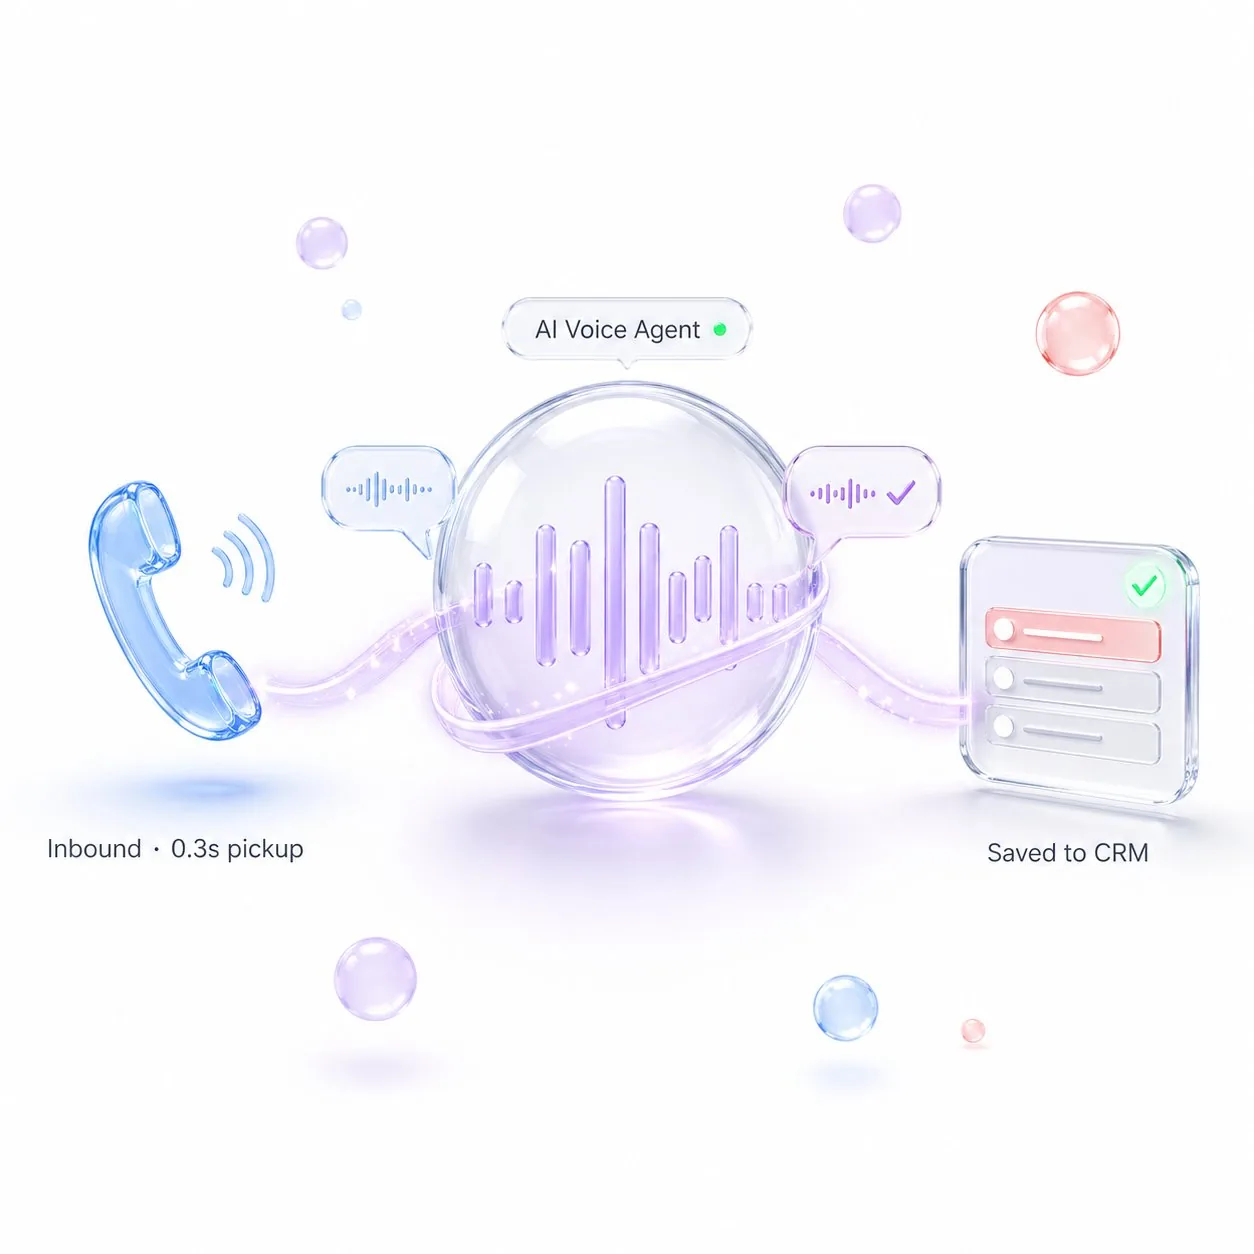
Результат: медианная задержка первого токена 180мс на нашем тестовом suite. P95 ниже 280мс. Это порог, на котором voice-агенты перестают ощущаться как AI и начинают ощущаться как человек.
14 языков, переключение посреди предложения
v1 требовал конфигурации под каждый язык. Клиентам на multilingual рынках приходилось поддерживать отдельных агентов. v2 определяет язык для каждого высказывания, и даже для каждого слова в code-switching сценариях.
Поддерживаются на запуске: английский, украинский, русский, польский, чешский, словацкий, румынский, венгерский, немецкий, французский, испанский, итальянский, португальский, нидерландский. Больше — по мере спроса клиентов.
На 40% ниже стоимость за минуту
Мы заменили самую тяжёлую модель в цепочке на кастомно обученную, которая в 4× меньше и не уступает по качеству на нашем voice-бенчмарке. Также мы перешли с per-token прайсинга на bulk inference, что работает, потому что мы можем batch-ить между клиентами.
Прайсинг для конечных клиентов падает соответственно: voice-минуты на плане Launch — с $0.08 до $0.05. Существующие контракты получат лучшую ставку без каких-либо действий.
Что далее
Voice Agent v2 доступен всем клиентам с сегодняшнего дня. Миграция автоматическая и zero-config, просто обновите дашборд.
В Q3: voice cloning для branded experiences, emotion-aware prosody, и self-service voice latency analyzer.